Mostrando entradas con la etiqueta Administración de Bases de Datos. Mostrar todas las entradas

jueves, 26 de abril de 2018

Conexion a MySQL desde Python

#!/usr/bin/python
import mysql.connector
from mysql.connector import errorcode

try:
  cnx = mysql.connector.connect(user='root',
                                password='tecnologico',
                                host='localhost',
                                port=3308,
                                database='biblioteca')
except mysql.connector.Error as err:
  if err.errno == errorcode.ER_ACCESS_DENIED_ERROR:
    print("Nombre de usuario o password incorrecto")
  elif err.errno == errorcode.ER_BAD_DB_ERROR:
    print("La base de datos no existe")
  else:
    print(err)
else:
  print('Conexion establecida')

  # cursor, clase para el manejo del SQL ???
  cursor = cnx.cursor()

  # Creamos la consulta SQL
  query = ("SELECT id_libro, nombre, editorial, edicion FROM libros")

  # Ejecutamos la consula SQL
  cursor.execute(query)

  # Mostramos todos los datos de la consulta
  for (id_libro, nombre, editorial, edicion) in cursor:
      print("Id: "+ str(id_libro) +" ,Titulo: " + nombre + ", Editorial: " + editorial + ", Edicion: " + str(edicion))

  # Cerramos cursor
  cursor.close()

  # Cerramos la conexion
  cnx.close()


Controladores MySQL para Python

Para conectar Python a una base de datos se necesita un controlador, que es una biblioteca utilizada para interactuar con la base de datos. Para la base de datos MySQL, están disponibles 3 opciones de controlador:
  • MySQL /Conector para Python
  • MySQLdb
  • PyMySQL
Pymysql es un paquete para la interacción con bases de datos MySQL escrito completamente en Python, a diferencia de su principal “competidor”, MySQLdb. Se presenta como una atractiva alternativa a este último y con razón, pues las ventajas son bastante relevantes. Corre en distintas implementaciones de Python: CPython, PyPy y IronPython. Además, su instalación resulta más sencilla al prescindir de código escrito en C. Por último, y de las que más aprecio personalmente, soporte para el conjunto de versiones 3.x.

Si cuentas con pip en tu ordenador, el proceso será de lo más sencillo. Ejecutar en la terminal:

pip install PyMySQL


martes, 24 de abril de 2018

Pip (administrador de paquetes)


pip es un sistema de gestión de paquetes utilizado para instalar y administrar paquetes de software escritos en Python. Muchos paquetes pueden ser encontrados en el Python Package Index (PyPI). Python 2.7.9 y posteriores (en la serie Python2), Python 3.4 y posteriores incluyen pip (pip3 para Python3) por defecto.

Una ventaja importante de pip es la facilidad de su interfaz de línea de comandos, el cual permite instalar paquetes de software de Python fácilmente desde solo una orden:

pip install nombre-paquete       

Los usuarios también pueden fácilmente desinstalar algún paquete:

pip uninstall nombre-paquete

Otra característica particular de pip es que permite gestionar listas de paquetes y sus números de versión correspondientes a través de un archivo de requisitos. Esto nos permite una recreación eficaz de un conjunto de paquetes en un entorno separado (p. ej. otro ordenador) o entorno virtual. Esto se puede conseguir con un archivo correctamente formateado requisitos.txt y la siguiente orden:

pip install -r requisitos.txt

Con pip es posible instalar un paquete para una versión concreta de Python, sólo es necesario reemplazar ${versión} por la versión de Python que queramos: 2, 3, 3.4, etc:

pip${versión} install nombre-paquete

domingo, 15 de abril de 2018

Unidad 2: Arquitectura del gestor

Objetivo de la Unidad

-Conocer los diferentes tipos de memoria y procesos que nos podemos encontrar en un sistema gestor de bases de datos.
-Tener conocimiento sobre el procedimiento de instalación y configuración de un DBMS.
-Saber los requisitos que pide cada DBMS y comandos generales de alta y baja.
-Poder elegir el mejor DBMS en cada situación.

2.1. Características del DBMS


Los sistemas de administración de bases de datos son usados para permitir a los usuarios acceder y manipular la base de datos proveyendo métodos para construir sistemas de procesamiento de datos para aplicaciones que requieran acceso a los datos.
Además proporcionan a los administradores las herramientas que les permitan ejecutar tareas de mantenimiento y administración de los datos.

Control de la redundancia de datos
Este consiste en lograr una mínima cantidad de espacio de almacenamiento para almacenar los datos evitando la duplicación de la información. De esta manera se logran ahorros en el tiempo de procesamiento de la información, se tendrán menos inconsistencias, menores costos operativos y hará el mantenimiento más fácil.

Compartimiento de datos
Una de las principales características de las bases de datos, es que los datos pueden ser compartidos entre muchos usuarios simultáneamente, proveyendo, de esta manera, máxima eficiencia.

Mantenimiento de la integridad

La integridad de los datos es la que garantiza la precisión o exactitud de la información contenida en una base de datos. Los datos interrelacionados deben siempre representar información correcta a los usuarios.

Soporte para Control de transacciones y recuperación de fallas
Se conoce como transacción toda operación que se haga sobre la base de datos. Las transacciones deben por lo tanto ser controladas de manera que no alteren la integridad de la base de datos. La recuperación de fallas tiene que ver con la capacidad de un sistema DBMS de recuperar la información que se haya perdido durante una falla en el software o en el hardware.

Independencia de los Datos
En las aplicaciones basadas en archivos, el programa de aplicación debe conocer tanto la organización de los datos como las técnicas que el permiten acceder a los datos. En los sistemas DBMS los programas de aplicación no necesitan conocer la organización de los datos en el disco duro. Este totalmente independiente de ello.

Seguridad
La disponibilidad de los datos puede ser restringida a ciertos usuarios. Según los privilegios que posea cada usuario de la base de datos, podrá acceder a mayor información que otros.


2.1.3 Requerimientos para instalación de la base de datos


Antes de instalar cualquier SGBD es necesario conocer los requerimientos de hardware y software, el posible software a desinstalar previamente, verificar el registro de Windows y el entorno del sistema, así como otras características de configuración especializadas como pueden ser la reconfiguración de los servicios TCP/IP y la modificación de los tipos archivos HTML para los diversos navegadores.


2.1.4 Instalación del software de base de datos en modo transaccional


Una base de datos en modo transaccional significa que la BD será capaz de que las operaciones de inserción y actualización se hagan dentro de una transacción, es un componente que procesa información descomponiéndola de forma unitaria en operaciones indivisibles, llamadas transacciones, esto quiere decir que todas las operaciones se realizan o no, si sucede algún error en la operación se omite todo el proceso de modificación de la base de datos, si no sucede ningún error se hacen toda la operación con éxito.

Una transacción es un conjunto de líneas de un programa que llevan insert o update o delete. Todo aquél software que tiene un log de transacciones (que es la "bitácora" que permite hacer operaciones de commit o rollback), propiamente es un software de BD; aquél que no lo tiene (v.g. D-Base), propiamente no lo es. Todo software de base de datos es transaccional; si el software de la BD no es "transaccional", en realidad NO es un "software" de BD; en todo caso, es un software que emula el funcionamiento de un verdadero software de BD. Cada transacción debe finalizar de forma correcta o incorrecta como una unidad completa. No puede acabar en un estado intermedio.

Se usan las siguientes métodos :
  • Begin TRans para iniciar la transacción. 
  • CommitTrans para efectuar los cambios con éxito. 
  • RollbackTrans para deshacer los cambios. 
Y depende que base de datos uses para efectuar las operaciones pero, es la misma teoría para cualquier BD.

2.1.5 Variables de ambiente y archivos importantes para instalación


Variables de Ambiente: Se usan para personalizar el entorno en el que se ejecutan los programas y para ejecutar en forma correcta los comandos del shell.

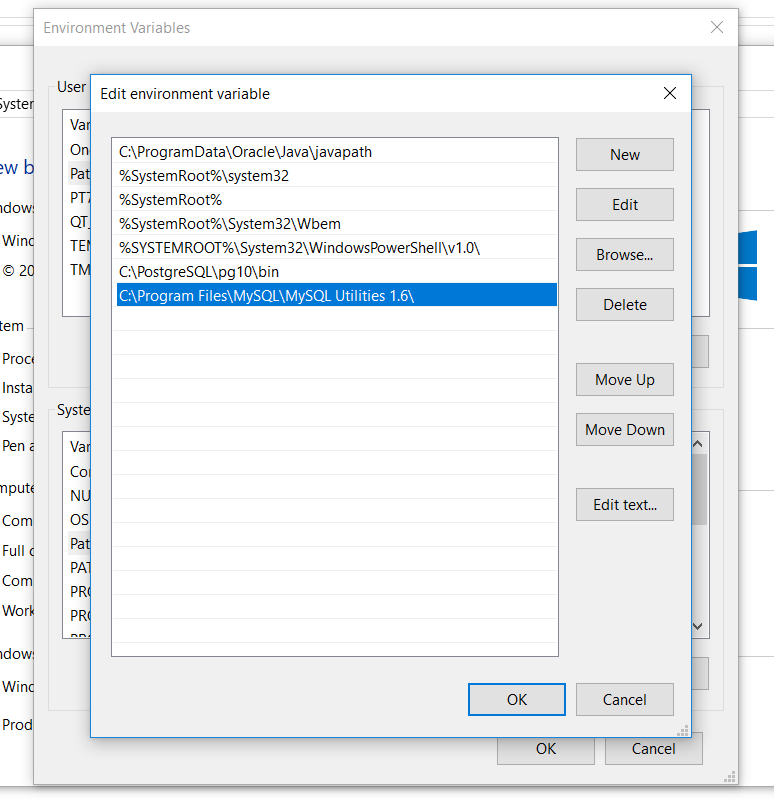
Variables de entorno declaradas por el instalador de MySQL en Windows 10:


Carpeta de archivos de MySQL en Windows 10:


A continuación se comentan las opciones más utilizadas de la sección mysqld (afectan al funcionamiento del servidor MySQL), se almacenan en el archivo my.cnf (o my.ini).

basedir = ruta: Ruta a la raíz MySQL.
console: Muestra los errores por consola independientemente de lo que se configure para log_error.
datadir = ruta: Ruta al directorio de datos.
default-table-type = tipo: Tipo de la Tabla InnoDB o, MyISAM.
flush: Graba en disco todos los comandos SQL que se ejecuten (modo de trabajo, sin transacción).
general-log = valor: Con valor uno, permite que funcione el archivo LOG para almacenar las consultas realizadas.
general-log-file = ruta: Indica la ruta al registro general de consultas.
language: Especifica el idioma de los lenguajes de error, normalmente esots archivos de lenguaje, están bajo /usr/local/share.
log-error = ruta: Permite indicar la ruta al registro de errores.
log = ruta: Indica la ruta al registro de consultas.
long-query-time = n: Segundos a partir de los cuales una consulta que tardes más, se considerará una consulta lenta.
og-bin = ruta: Permite indicar la ruta al registro binario.
pid-file = ruta: Ruta al archivo que almacena el identificador de proceso de MySQL.
port = puerto: Puerto de escucha de MySQL.
skip-grant-tables: Entra al servidor saltándose las tablas de permisos, es decir todo el mundo tiene privilegios absolutos.
skip-networking: El acceso a MySQL se hará solo desde el servidor local.
slow-query-log = 0|1: Indica si se hace LOG de las consultas lentas.
slow-query-log-file = ruta: Ruta al archivo que hace LOG de las consultas lentas.
socket = ruta: Archivo o nombre de socket a usar en las conexiones locales.
standalone: Para Windows, hace que el servidor no pase a ser un servicio.
user = usuario: Indica el nombre de usuario con el que se iniciará sesión en MySQL.
tmpdir = ruta: Ruta al directorio para archivos temporales.

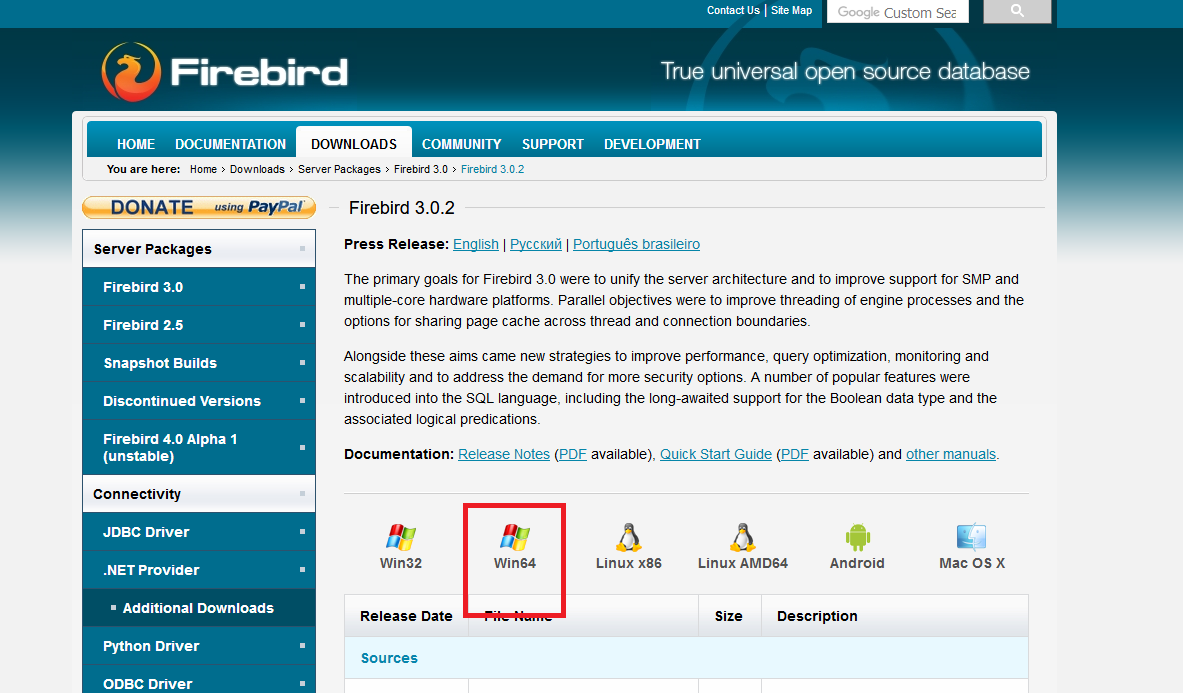
2.1.6 Procedimiento general de instalación de un DBMS (Firebird)


2.1.7 Procedimiento para Configuración de un DBMS


Para configurar nuestro DBMS podemos acceder a las siguientes pantallas, para Oracle o MySQL. El esquema de una base de datos (en inglés, Database Schema) describe la estructura de una Base de datos, en un lenguaje formal soportado por un Sistema administrador de Base de datos (DBMS). En una Base de datos Relacional, el Esquema define sus tablas, sus campos en cada tabla y las relaciones entre cada campo y cada tabla.
Oracle generalmente asocia un 'username' como esquemas en este caso SYSTEM y HR (Recursos humanos).
Por otro lado MySQL presenta dos esquemas information_schema y MySQL ambos guardan información sobre privilegios y procedimientos del gestor y no deben ser eliminados.


Optamos por Detailed Configuration, de modo que se optimice la configuración del servidor MySQL.

Dependiendo del uso que vayamos a darle a nuestro servidor deberemos elegir una opción u otra, cada una con sus propios requerimientos de memoria. Puede que te guste la opción Developer Machine, para desarrolladores, la más apta para un uso de propósito general y la que menos recursos consume. Si vas a compartir servicios en esta máquina, probablemente Server Machine sea tu elección o, si vas a dedicarla exclusivamente como servidor SQL, puedes optar por Dedicated MySQL Server Machine, pues no te importará asignar la totalidad de los recursos a esta función.


De nuevo, para un uso de propósito general, te recomiendo la opción por defecto, Multifunctional Database.


InnoDB es el motor subyacente que dota de toda la potencia y seguridad a MySQL. Su funcionamiento requiere de unas tablas e índices cuya ubicación puedes configurar. Sin causas de fuerza mayor, acepta la opción por defecto.


Esta pantalla nos permite optimizar el funcionamiento del servidor en previsión del número de usos concurrentes. La opción por defecto, Decision Support (DSS) / OLAP será probablemente la que más te convenga.


Deja ambas opciones marcadas, tal como vienen por defecto. Es la más adecuada para un uso de propósito general o de aprendizaje, tanto si eres desarrollador como no. Aceptar conexiones TCP te permitirá conectarte al servidor desde otras máquinas (o desde la misma simulando un acceso web típico).


Hora de decidir qué codificación de caracteres emplearás, salvo que quieras empezar a trabajar con Unicode porque necesites soporte multilenguaje, probablemente Latin1 te sirva (opción por defecto).


Instalamos MySQL como un servicio de Windows (la opción más limpia) y lo marcamos para que el motor de la base de datos arranque por defecto y esté siempre a nuestra disposición. La alternativa es hacer esto manualmente.

Además, me aseguro de marcar que los ejecutables estén en la variable PATH, para poder invocar a MySQL desde cualquier lugar en la línea de comandos.


Pon una contraseña al usuario root. Esto siempre es lo más seguro.

Si lo deseas, puedes indicar que el usuario root pueda acceder desde una máquina diferente a esta, aunque debo advertirte de que eso tal vez no sea una buena práctica de seguridad.


Última etapa, listos para generar el fichero de configuración y arrancar el servicio.


Sólo damos al botón de Finalizar y terminamos con la configuración del DBMS.


2.1.8 Comandos Generales de Alta y Baja del DBMS


Una tabla es un sistema de elementos de datos (atributo - valores) que se organizan que usando un modelo vertical - columnas (que son identificados por su nombre)- y horizontal filas. Una tabla tiene un número específico de columnas, pero puede tener cualquier número de filas. Cada fila es identificada por los valores que aparecen en un subconjunto particular de la columna que se ha identificado por una llave primaria.

Definiendo cómo es almacenada la información

CREATE DATABASE se utiliza para crear una nueva base de datos vacía.
DROP DATABASE se utiliza para eliminar completamente una base de datos existente.
CREATE TABLE se utiliza para crear una nueva tabla, donde la información se almacena realmente.
ALTER TABLE se utiliza para modificar una tabla ya existente.
DROP TABLE se utiliza para eliminar por completo una tabla existente.

Manipulando los datos

SELECT se utiliza cuando quieres leer (o seleccionar) tus datos.
INSERT se utiliza cuando quieres añadir (o insertar) nuevos datos.
UPDATE se utiliza cuando quieres cambiar (o actualizar) datos existentes.
DELETE se utiliza cuando quieres eliminar (o borrar) datos existentes.
REPLACE se utiliza cuando quieres añadir o cambiar (o reemplazar) datos nuevos o ya existentes.
TRUNCATE se utiliza cuando quieres vaciar (o borrar) todos los datos de la plantilla.

Conclusiones de la unidad


Los sistemas gestores de bases de datos nacieron para facilitar el desarrollo y avance de las empresas. Sabemos también que la información crecía día a día, y conforme iba creciendo Surgieron necesidades, que eran preciso suplir para mantener a flote la Empresa en el mundo moderno donde la información es la base del éxito.
Los recursos utilizados por los SGBD van desde una red, maquina, hasta sistemas operativos, pero su funcionamiento varía muy poco dependiendo de las cualidades que tengan dichos recursos, de cualquier modo el propósito del SGBD sigue siendo el mismo: Administrar Información. Con esto en mente empezaremos la descripción del funcionamiento de los SGBD para entender y conceptualizar las ventajas del uso de estas herramientas tan útiles y versátiles para nosotros como futuros ingenieros de sistemas.

lunes, 19 de marzo de 2018

Arquitectura física de una base de datos en SQL Server


La unidad fundamental del almacenamiento de datos en SQL Server es la página. El espacio en disco asignado a un archivo de datos (.mdf o .ndf) de una base de datos se divide lógicamente en páginas numeradas de forma contigua de 0 a n. Las operaciones de E/S de disco se realizan en el nivel de página. Es decir, SQL Server lee o escribe páginas de datos enteras.

Páginas
En SQL Server, el tamaño de página es de 8 KB. Esto significa que las bases de datos de SQL Server tienen 128 páginas por megabyte. Cada página empieza con un encabezado de 96 bytes, que se utiliza para almacenar la información del sistema acerca de la página. Esta información incluye el número de página, el tipo de página, el espacio libre en la página y el Id. de unidad de asignación del objeto propietario de la página.


Tipo de página Contenido
DatosLas filas de datos con todos los datos, excepto los datos text, ntext, image, nvarchar(max), varchar(max), varbinary(max) y xml, cuando text in row está establecido en ON.
ÍndiceEntradas de índice.
Texto o imagenTipos de datos de objetos grandes:
  • Datos text, ntext, image, nvarchar(max), varchar(max), varbinary(max) y xml.
Columnas de longitud variable cuando la fila de datos sobrepasa 8 KB:
  • varchar, nvarchar, varbinary y sql_variant.
Mapa de asignación global, Mapa de asignación global compartido Información acerca de si se han asignado las extensiones.
Espacio disponible en páginasInformación acerca de la asignación de páginas y el espacio libre disponible en las páginas.
Mapa de asignación de índicesInformación acerca de las extensiones utilizadas por una tabla o un índice por unidad de asignación.
Mapa cambiado masivamenteInformación acerca de las extensiones modificadas por operaciones masivas desde la última instrucción BACKUP LOG por unidad de asignación.
Mapa cambiado diferencialInformación acerca de las extensiones que han cambiado desde la última instrucción BACKUP DATABASE por unidad de asignación.

Las filas de datos se colocan en las páginas una a continuación de otra, empezando inmediatamente después del encabezado. Al final de la página, comienza una tabla de desplazamiento de fila y cada una de esas tablas contiene una entrada para cada fila de la página. Cada entrada registra la distancia del primer byte de la fila desde el inicio de la página. Las entradas de la tabla de desplazamiento de fila están en orden inverso a la secuencia de las filas de la página.

Extensiones
Las extensiones son la unidad básica en la que se administra el espacio. Una extensión consta de ocho páginas contiguas físicamente, es decir 64 KB. Esto significa que las bases de datos de SQL Server tienen 16 extensiones por megabyte.

Para hacer que la asignación de espacio sea eficaz, SQL Server no asigna extensiones completas a tablas con pequeñas cantidades de datos. SQL Server tiene dos tipos de extensiones:
  • Las extensiones uniformes son propiedad de un único objeto; sólo el objeto propietario puede utilizar las ocho páginas de la extensión.
  • Las extensiones mixtas, que pueden estar compartidas por hasta ocho objetos. Cada una de las 8 páginas de la extensión puede ser propiedad de un objeto diferente.

Archivos de base de datos
Las bases de datos de SQL Server 2005 utilizan tres tipos de archivos:
  • Archivos de datos principales: El archivo de datos principal es el punto de partida de la base de datos y apunta a los otros archivos de la base de datos. Cada base de datos tiene un archivo de datos principal. La extensión recomendada para los nombres de archivos de datos principales es .mdf.
  • Archivos de datos secundarios: Los archivos de datos secundarios son todos los archivos de datos menos el archivo de datos principal. Puede que algunas bases de datos no tengan archivos de datos secundarios, mientras que otras pueden tener varios archivos de datos secundarios. La extensión de nombre de archivo recomendada para los archivos de datos secundarios es .ndf.
  • Archivos de registro: Los archivos de registro almacenan toda la información de registro que se utiliza para recuperar la base de datos. Como mínimo, tiene que haber un archivo de registro por cada base de datos, aunque puede haber varios. La extensión de nombre de archivo recomendada para los archivos de registro es .ldf.

Páginas de archivo de datos
Las páginas de un archivo de SQL Server 2005 están numeradas secuencialmente, comenzando por 0 para la primera página del archivo. Cada archivo de una base de datos tiene un número de identificador único. Para identificar de forma única una página de una base de datos, se requiere el identificador del archivo y el número de la página.

Archivos de instantáneas de bases de datos
La forma de archivo que utiliza una instantánea de base de datos para almacenar sus datos de copia por escritura depende de si la instantánea la ha creado un usuario o se utiliza internamente:
  • Una instantánea de base de datos que crea un usuario almacena sus datos en uno o más archivos dispersos. La tecnología de archivos dispersos es una característica del sistema de archivos NTFS. Al principio, un archivo disperso no incluye datos de usuario y no se le asigna espacio en disco.
  • Las instantáneas de bases de datos las utilizan internamente algunos comandos DBCC. Entre estos comandos se incluyen: DBCC CHECKDB, DBCC CHECKTABLE, DBCC CHECKALLOC y DBCC CHECKFILEGROUP. Una instantánea de base de datos interna utiliza secuencias de datos alternativos dispersos de los archivos de base de datos originales.

Arquitectura del manejador de bases de datos Oracle

Archivos

  • Control (ctl): almacenan información acerca de la estructura de archivos de la base.
  • Rollback (rbs): cuando se modifica el valor de alguna tupla en una transacción, los valores nuevos y anteriores se almacenan en un archivo, de modo que si ocurre algún error, se puede regresar (rollback) a un estado anterior.
  • Redo (rdo): bitácora de toda transacción, en muchos dbms incluye todo tipo de consulta incluyendo aquellas que no modifican los datos.
  • Datos (dbf): el tipo más común, almacena la información que es accesada en la base de datos.
  • Indices (dbf) (dbi): archivos hermanos de los datos para acceso rápido.
  • Temp (tmp): localidades en disco dedicadas a operaciones de ordenamiento o alguna actividad particular que requiera espacio temporal adicional.

Memoria

  • Shared Global Area (SGA): es el área más grande de memoria y quizás el más importante.
  • Shared Pool: es una caché que mejora el rendimiento ya que almacena parte del diccionario de datos y el parsing de algunas consultas en SQL.
  • Redo Log Buffer: contiene un registro de todas las transacciones dentro de la base, las cuales se almacenan en el respectivo archivo de Redo y en caso de siniestro se vuelven a ejecutar aquellos cambios que aún no se hayan reflejado en el archivo de datos (commit).
  • Large Pool: espacio adicional, generalmente usado en casos de multithreading y esclavos de I/O.
  • Java Pool: usado principalmente para almacenar objetos Java.
  • Program Global Area (PGA): información del estado de cursores/apuntadores.
  • User Global Area(UGA): información de sesión, espacio de stack.

Procesos

  • System Monitor: despierta periódicamente y realiza algunas actividades entre las que se encuentran la recuperación de errores, recuperación de espacio libre en tablespaces y en segmentos temporales.
  • Process Monitor: limpia aquellos procesos que el usuario termina de manera anormal, verificando consistencias, liberación de recursos, bloqueos.
  • Database Writer: escribe bloques de datos modificados del buffer al disco, aquellas transacciones que llegan a un estado de commit.
  • Log Writer: escribe todo lo que se encuentra en el redo log buffer hacia el redo file.
  • Checkpoint: sincroniza todo lo que se tenga en memoria, con sus correspondientes archivos en disco.

martes, 13 de marzo de 2018

Memoria de una base de datos


Área Global del Sistema (System Global Area, SGA)

El Área Global del Sistema (SGA) es un grupo de estructuras de la memoria compartida que contiene datos e información de control de una instancia de una BD. Si varios usuarios se conectan de forma concurrente a la misma instancia, entonces los datos se comparten en el SGA, por lo que también se llama shared global area.

Una instancia en Oracle se compone de un SGA y de procesos. Cuando se crea una instancia, Oracle asigna memoria a un SGA automáticamente y esta se devuelve al sistema operativo cuando la instancia se cierra. Por tanto, cada instancia posee su propio SGA.

Una parte del SGA contiene información general acerca del estado de la base de datos y de la instancia, a la que los procesos en segundo plano necesitan acceder (SGA fija), pero no se almacenan los datos de usuario. El SGA también incluye información de comunicación entre procesos, como la información de bloqueos.

Buffer Cache (o Database Buffer Cache)

Su función es mantener bloques de datos más recientemente leídos directamente de los archivos de datos, esto se hace para un mejor desempeño pues si los datos son de nuevo requeridos por un usuario, su acceso es más rápido.

Cuando se procesa una consulta, el servidor busca los bloques de datos requeridos en esta estructura. Si el bloque no se encuentra en esta estructura, el proceso servidor lee el bloque de la memoria secundaria y coloca una copia en esta estructura. De esta forma, otras peticiones que requieran de este bloque de datos no requerirán de acceso a memoria secundaria (lecturas físicas).

Los bloques pueden contener datos modificados que no son permanentemente escritos a disco y los cuales maneja Oracle de una manera consistente para atender la concurrencia de los usuarios conectados a la base de datos, dichos usuarios comparten el acceso a esta área. Los bloques modificados se llamas bloques sucios.


Área de SQL Compartido, Shared SQL Pool

En esta zona se encuentran las sentencias SQL que han sido analizadas. El análisis sintáctico de las sentencias SQL lleva su tiempo y Oracle mantiene las estructuras asociadas a cada sentencia SQL analizada durante el tiempo que pueda para ver si puede reutilizarlas.

Antes de analizar una sentencia SQL, Oracle mira a ver si encuentra otra sentencia exactamente igual en la zona de SQL compartido. Si es así, no la analiza y pasa directamente a ejecutar la que mantiene en memoria. De esta manera se premia la uniformidad en la programación de las aplicaciones. La igualdad se entiende que es lexicográfica, espacios en blanco y variables incluidas.

La base de datos Oracle asigna memoria a la shared pool cuando una nueva instrucción sql se analiza. El tamaño de esta memoria depende de la complejidad de la instrucción. Si toda la shared pool ya ha sido asignada la base de datos Oracle puede liberar elementos de la shared pool hasta que haya suficiente espacio libre para nuevas sentencias. Al liberar un elemento de la shared pool el sql asociado debe ser recompilado y reasignado a otra área de sql compartida la próxima vez que se ejecute.

El contenido de la zona de SQL compartido es:
  • Las sentencias SQL y PL/SQL (texto de la sentencia)
  • Plan de ejecución de la sentencia SQL.
  • Lista de objetos referenciados.

Large Pool

El administrador de la base de datos puede configurar esta área de memoria opcional, para proveer localidades más amplias de memoria para:
  • Memoria de sesiones.
  • Procesos de I/O del servidor
  • Backups de la base de datos y operaciones de recuperación.
Al asignar espacios dentro de large pool para un servidor compartido, Oracle puede usar la shared pool principalmente para guardar en caché las sentencias compartidas de sql y evitar la sobrecarga causada por la disminución de la caché de sql compartida. Además la memoria para backup y operaciones de recuperación y para procesos de I/O del servidor es asignada en buffers de algunos cientos de kilobytes, por lo que la large pool mucho más capaz de satisfacer dicha demanda de memoria que la shared pool.

Java Pool

La memoria java pool es usada en la memoria del servidor para todas las sesiones que utilicen código java y datos en la JVM. Esta memoria es usada de diferentes maneras dependiendo del modo en el que la base de datos esté corriendo.

Algunas de las cuales son:
  • Análisis sintáctico de código y scripts en Java.
  • Tareas de instalación relacionada con aplicaciones Java.
  • Procedimientos almacenados de código Java.
La Java Pool utiliza el algoritmo LRU (Least-Recently-Used), el cual se encarga de mantener en memoria el código Java que se utiliza con mayor frecuencia.


miércoles, 7 de marzo de 2018

Componentes de un Sistema Gestor de Bases de Datos

Un  sistema  de  bases  de  datos  se  divide  en  módulos  que se  encargan  de  cada  una  de  las  responsabilidades  del  sistema  completo.

Los componentes funcionales de un sistema de bases de datos se pueden dividir a grandes rasgos en:


Usuarios

  • Normales: Usuarios que no requieren preparación especial en el manejo de base de datos y que utilizan el sistema a través de programas de aplicación que han sido escritos para ellos.
  • Programadores de aplicaciones: Usuarios de la base de datos y escriben programas de aplicación. Pueden llegar a utilizar herramientas DRA (Desarrollo Rápido de Aplicaciones), con las que pueden crear formularios e informes con poco esfuerzo de programación.
  • Sofisticados: Son quienes utilizan la base de datos a través de consultas escritas en un lenguaje de consultas.
  • DBA: Su función es administrar la base de datos por lo tanto tiene acceso total.

Componentes de procesamiento de consultas

  • Compilador de LMD: Traduce las instrucciones del LMD en lenguaje de consultas a instrucciones a bajo nivel que entiende el motor de evaluación de consultas.
  • Precompilador del LMD incorporado: Convierte las instrucciones de LMD incorporadas en un programa de aplicación en llamadas a procedimientos normales en el lenguaje anfitrión.
  • Intérprete del LDD: Interpreta las instrucciones del LDD y las registra en un conjunto de tablas que contiene metadatos.
  • Motor de evaluación de consultas: Ejecuta las instrucciones a bajo nivel generadas por el compilador del LMD.

Componentes de gestión de almacenamiento

  • Gestor de autorización e integridad: Comprueba que se satisfagan las ligaduras de integridad y la autorización de los usuarios para acceder a los datos.
  • Gestor de transacciones: Asegura que la base de datos quede en un estado consistente a pesar de los fallos del sistema, y que las ejecuciones de transacciones concurrentes ocurran sin conflicto.
  • Gestor de archivos: Gestiona la reserva de espacio de almacenamiento de disco, y las estructuras de datos usadas para representar la información almacenada en disco.
  • Gestor de memoria intermedia: Es responsable de traer los datos del disco de almacenamiento a memoria principal y decidir qué datos tratar en la memoria caché.


Almacenamiento en disco

  • Diccionario de datos: Dentro de él se encuentra la lista de todos los elementos que forman parte del flujo de datos de todo el sistema. Almacena el conjunto de esquemas y especifica cada archivo y su ubicación, también incluye información acerca de qué programas utilizan qué datos, y a que usuarios les interesa un informe u otro.
  • Indices: Que se utilizan para buscar más rápidamente un registro. Estos, junto con los datos estadísticos son archivos que son almacenados en disco.

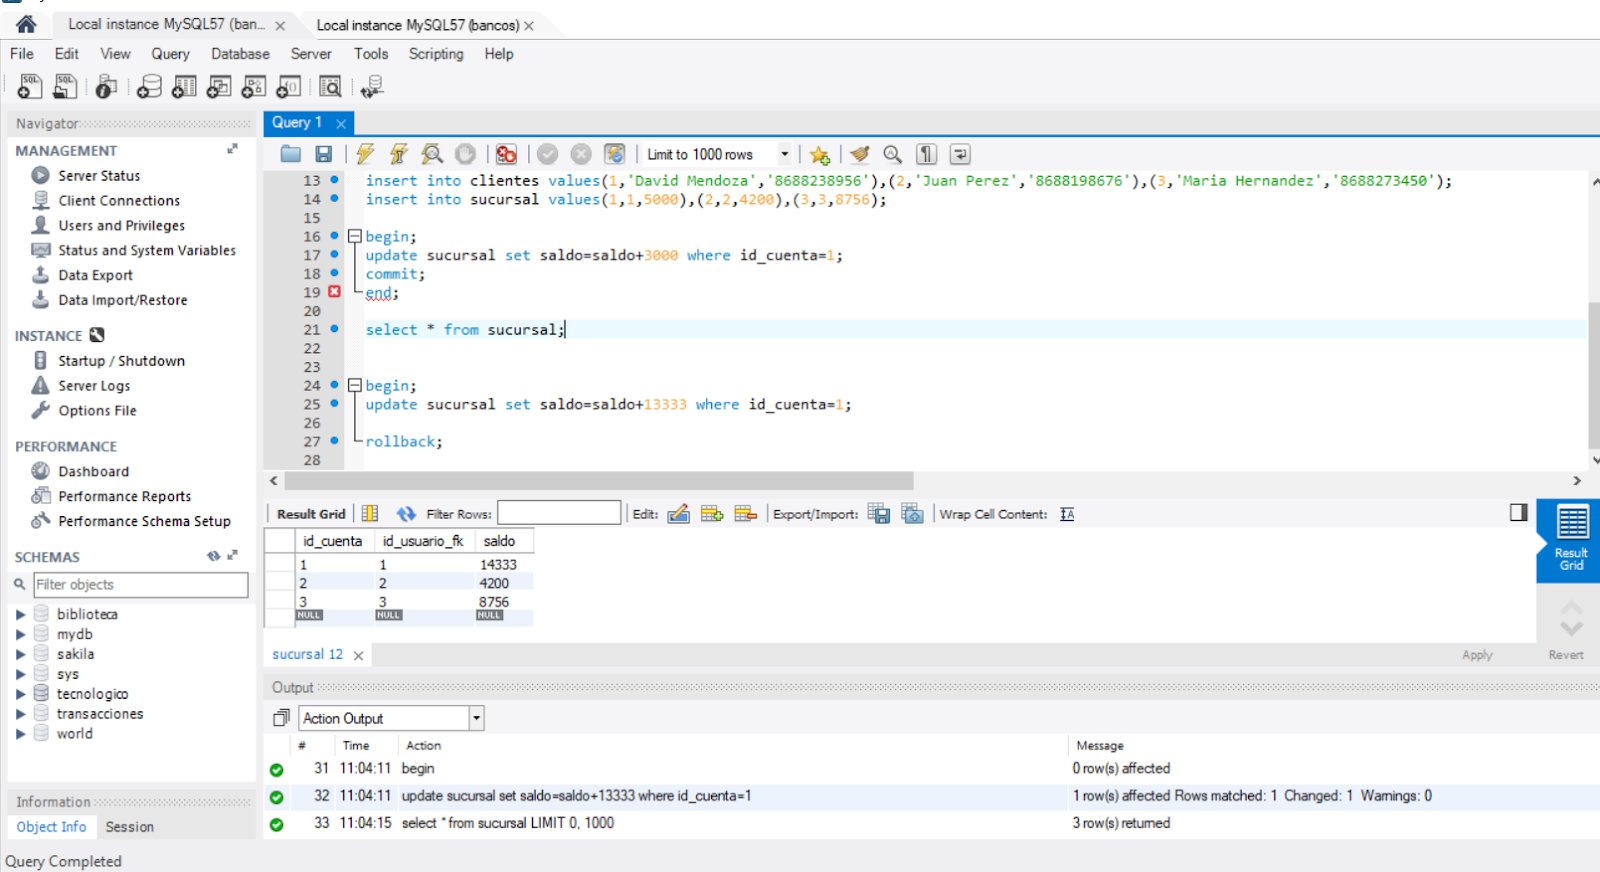
Práctica del video: Explicación de los comandos commit y rollback